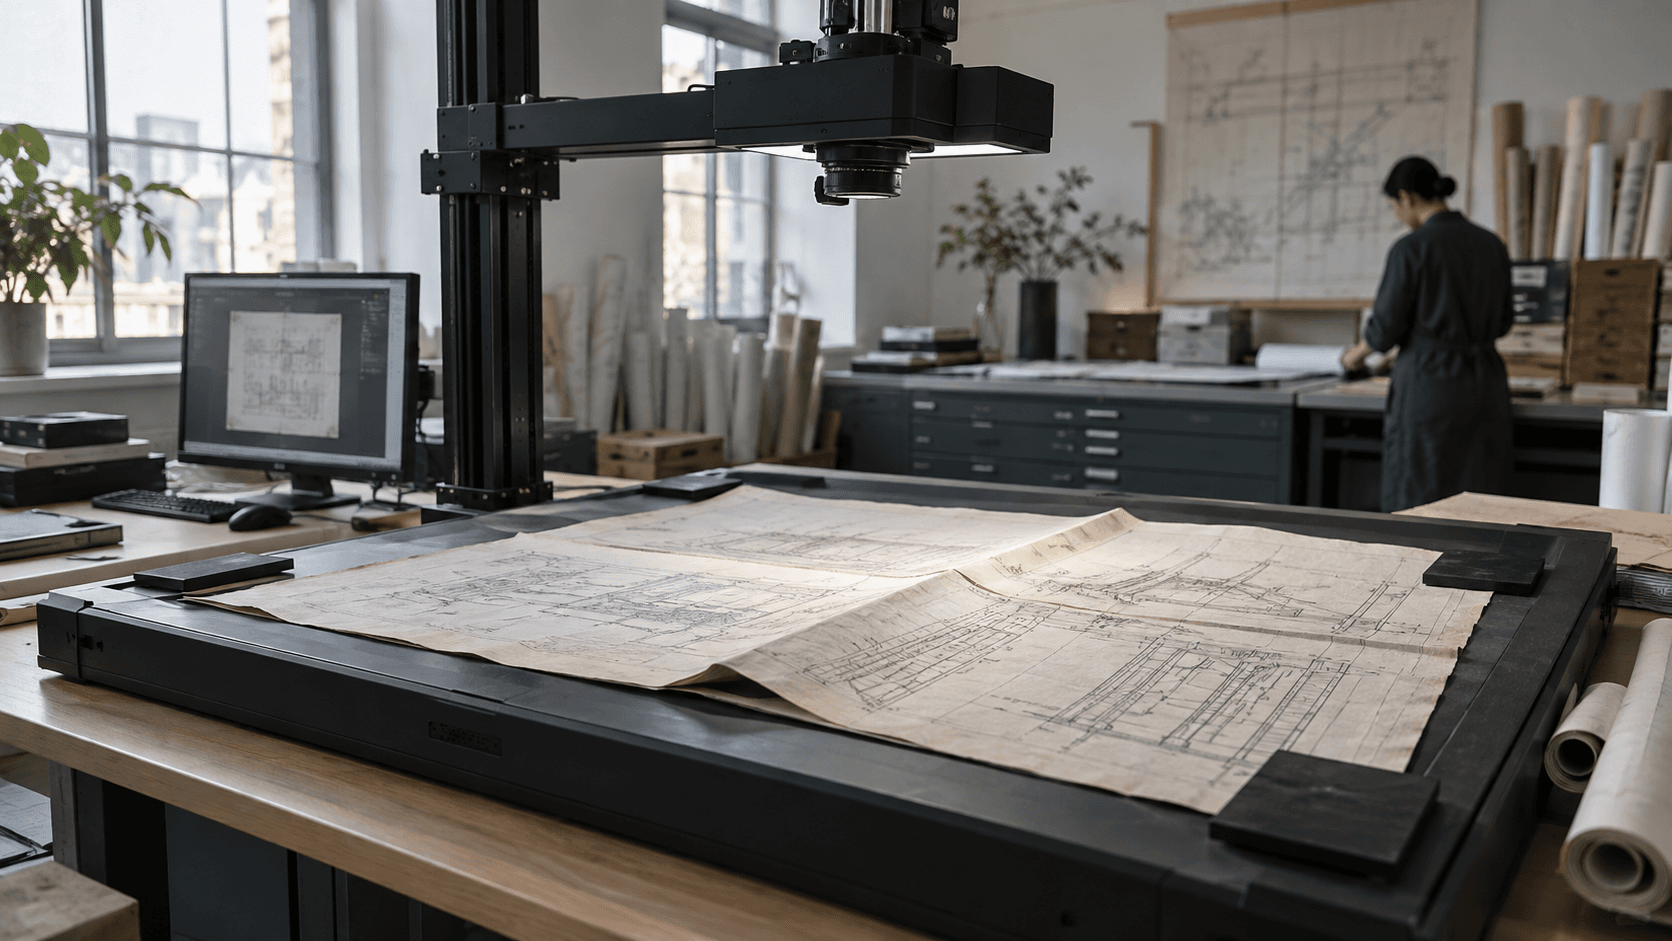
OCR 将图像中的文字转换为可处理文本,文档理解还涉及标题、表格和版面关系。识别后应保留原图与位置,对型号、数字、单位和关键条件重点核对。文本读起来通顺,不能证明所有字段都识别正确。
先确认文件是什么类型
带文字层的 PDF、扫描 PDF 和手机照片,处理方式与质量可能不同。先测试文字能否直接提取,再判断是否需要 OCR。倾斜、反光和小字号会增加核对难度。
资料来源也要明确。客户提供的扫描件是否完整、页码是否连续、附件是否为有效版本,应在识别前检查,避免把缺页问题误认为模型理解不足。
表格和图示需要保留关系
提取参数时同时保留行标题、列标题与单位。跨页表格可能在下一页继续使用上一页的表头,若脱离上下文,字段会被错误对应。合并单元格也需特别检查。
图示里的箭头、位置和标注包含文字之外的信息。可以给出原图位置及辅助说明,但不能用生成文字替代对重要图形的核对,尤其不能根据模糊图像补造规格。
区分识别结果与确认结果
保留待核对状态,让业务人员直接打开对应页或图。对影响较大的字段逐项确认后,再进入产品资料或业务记录。识别置信分数可辅助筛选,但不能代替业务判断。
先用不同质量的样本检验,再决定批量处理范围。知识库导入前,还应检查提取文本能否独立理解,并将标题、原始来源和版本一并保存,方便后续查证。
识别文字之后,保留表格与页面关系
扫描文档里的标题、正文、表格和脚注承担不同含义。一个数值脱离所在行列后,可能无法判断对应型号或单位。处理技术资料时,应保存页码、区域或表格位置,方便后续提取与核对,而不是仅把识别出的文字拼成连续段落。
同一份文件也可能同时含有可提取文字和扫描页面。先抽查不同页面类型,再选择解析方式。旋转、模糊、手写和跨页表格会带来不同错误,不能用封面识别成功代表整份文件处理合格。
对高影响字段保留原图核对入口
产品编码、金额、尺寸和单位应能够回到原页面。可以用规则发现异常格式或缺失值,再让业务人员核对必要部分。相似字符替换后仍可能通过格式检查,所以“看起来像正确编码”不等于它就是原文内容。
验收样例覆盖正文、表格和边界页面,分别记录识别遗漏、结构丢失与字段误配。只有清楚知道错误属于哪一层,才能决定重新扫描、改解析方式还是调整后续提取。
让每个关键提取值能打开原页
对照扫描件检查型号后缀、金额符号、上下标、单位和跨页表头,保存页码或区域。先让企业资料负责人确认差异,再考虑批量处理;识别文通顺不等于参数已确认。
参考来源
外部资料用于说明方法;具体功能、费用和许可条件以供应商现行说明及实际验证为准。
- Dify Docs|文档分段设置分段方式与文档预处理机制
- 秩启|企业资料准备企业资料、角色与待核事项整理;保存草案不等于形成正式业务规则
- Google Cloud|文档理解多模态文档输入与理解能力;业务适用性仍需实测