要点
验收应比较同一类任务在使用 AI 前后的完整处理过程。除了生成耗时,还要计算资料准备、人工核对和返工,并观察同事是否持续使用。先约定合格标准,再用保留的样例复测,避免凭一次漂亮的结果作决定。
先留下原有处理记录
选取具有代表性的任务,记录原来的处理步骤、完成时间和常见错误。每条样例保留输入与核对结果,难例和失败例也要纳入。没有原始记录,很难判断变化来自 AI,还是任务本身变简单了。
质量指标应能被业务人员解释。例如询价摘要检查参数是否完整,知识问答检查来源是否支持结论。尽量少用“智能程度”这类没有一致判断方法的评分。
计算完整成本
模型生成很快,但如果审核者需要重新查完所有资料,实际节省可能很小。把准备、等待、审核、修订及失败处理分别记录,才能知道时间花在哪里。
费用也应覆盖重试、文档解析、检索以及平台运行。先按任务观察,不急于把小样本节省比例推广到整个部门。一次试用不能直接证明长期收益。
关注持续采用的原因
收集使用者主动放弃工具的情况:入口难找、结果不稳定、资料过期或审核负担过大。把这些原因与运行日志对应,通常比继续增加功能更有用。
完成标准可以是特定任务达标、异常有人处理、使用者能独立完成。验收后再决定扩展到相近任务,新增场景应重新补样例,而不是沿用原任务的合格结论。
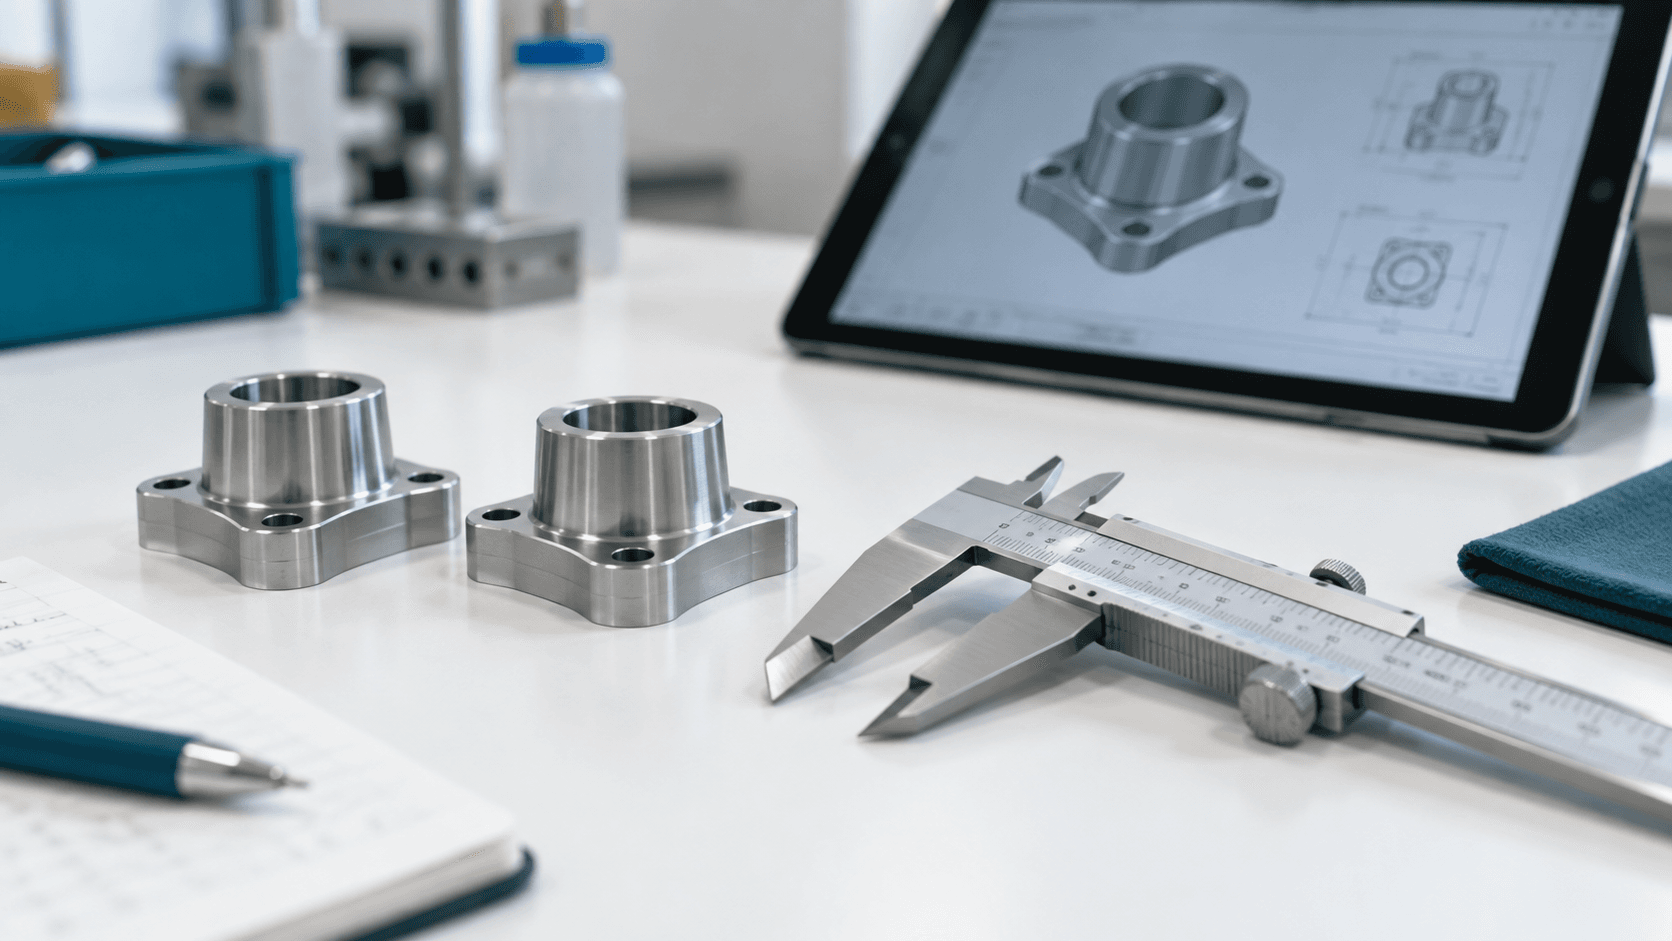
让同一组询盘接受前后对照
保留相同难度的询盘样例,分别核对字段、原文依据和总处理时间。把失败与人工补做也记入结果,只报告这组样本的观察;通过某次测试后,再按新增范围补样例。
参考来源
外部资料用于说明方法;具体功能、费用和许可条件以供应商现行说明及实际验证为准。
- 秩启|分工与建设方法企业分工、流程与建设方法;属于本项目方法说明,不是外部效果证据
- Microsoft|2026 Work Trend Index组织与人机协作趋势;不作为本地搜索量或效果依据